AI PROMPT ATLAS
從一個詞,
找到她的每一種樣子。
這裡整理同一位動畫人物的服裝、材質、動作與表情提示詞。先看條件,再讀完整描述;有通過審核的圖片時,也能對照它真正呈現的樣子。
從單件提示詞開始,或到作品集查看校服搭配。生成圖片先在本機待審區核對。
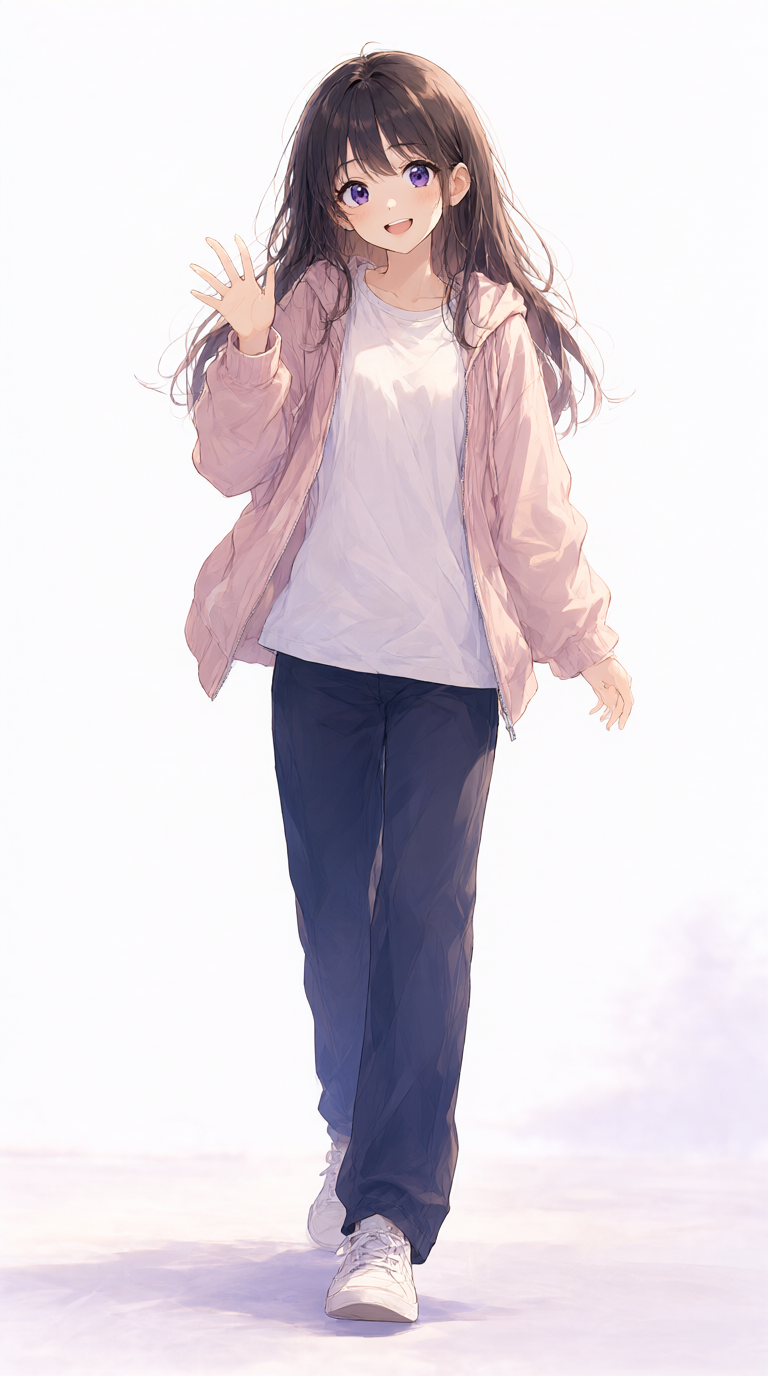 固定人物 / 畫風參考 · 生成方式未記錄 · 模型未記錄
本站的目的
AI 生圖日漸成熟,卻常因腦中的畫面難以用文字完整表達,讓生成結果與期待出現落差。本網站透過清楚的名詞、層級分類與實際圖片,協助你描述人物、衣物、背景、畫風與視角,並理解不同提示詞如何影響畫面。
隨著生成技術進步,AI 或許也能從較模糊的描述產生理想作品。因此,本站不以評判圖片好壞為目標,而是協助你檢視:提示詞是否準確傳達了原本的想法。
AI 如何生成圖片
文生圖:文字 → 圖片
輸入提示詞,模型把人物、衣物與畫風等文字描述作為生成條件。以常見的擴散模型為例,畫面從隨機噪聲開始,經過逐步去噪形成圖片;沒有輸入參考圖片,因此外貌與構圖通常有較多變化。
圖文生圖:參考圖片+文字 → 圖片
同時提供圖片與提示詞,模型利用圖片中的外觀或構圖資訊,再依文字生成新畫面。傳統擴散式圖生圖會將原圖編碼並加入噪聲,再依文字逐步去噪;參考圖引導或圖片編輯工具也可能採用其他流程。參考影響強度與提示詞,都會改變保留原圖與重新創作的程度。
本站將實際有輸入圖片及文字的生成統稱為「圖文生圖」,不代表每個工具都採用相同演算法。使用參考圖也不保證人物或畫風完全一致。
- 讀取條件人物、衣服、畫風與參考圖,提供畫面方向。
- 逐步生成從隨機起點反覆調整,讓畫面符合描述。
- 檢查結果核對人物、衣物、手腳與取景,再保存完整紀錄。
哪些變量會改變結果?
- 提示詞與描述範圍
- 「衣服」留下許多可能;指定「白色、棉質、短袖襯衫」可縮小衣物外觀的範圍。相互矛盾的描述也會影響結果。
- 模型與版本、畫風
- 不同模型的解讀能力不同;線條、上色方式與風格設定也會改變同件衣服的呈現。
- 人物與參考圖
- 人物描述、使用的參考圖,以及參考影響強度,會影響臉型、比例與衣物。
- 姿勢、光線與取景
- 相同衣服換個角度、鏡頭距離或光源,看到的輪廓、材質與色彩就可能不同。
- Seed 與生成設定
- Seed 控制隨機起點;工具支援時,步數、引導強度、採樣方式與尺寸也會影響輸出。
描述更細緻,不保證每次完全一樣。要比較單一變量,還需要固定人物、畫風、參考、鏡頭、模型與設定,並記錄 Seed。這批工具未回報精確模型與 Seed,圖片仍需逐張審查。
提示詞圖鑑
從人物、背景、畫風與視角分類,學習完整提示詞。
02 / PORTFOLIO作品集
比較特別提示詞的不同模型結果,或查看整套服裝搭配。